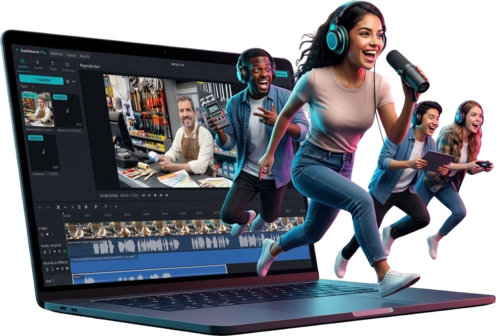
画面的形状取自你导入的素材,所以你是这三个人中的哪一个,应用并不在意。
AI 只把原始对白抬起来,音乐和音效留在原处。你对着画面表演,逐帧对齐。
竖着拍的,就竖着导出。对着你自己的画面录下另一种语言,交付同一个文件,只是换了声音。
把声音抽走,音乐留下,换上你自己的——字幕用应用自带的字体烧进画面。
导入一段视频,它的音频会作为独立轨道进来。如果影片带有多条语言 轨道,你可以选择导入哪些。
分离模型在设备上运行,把原始对白抬出来,留下音乐和音效。如果影片 本身就带有音乐与音效轨道,DubWeaver 会找到并直接使用它 — 比任何模型算出来的都好。
DubWeaver 把轨道读一遍,标出每句台词的起止——Pro Tools 里把这一步叫 Strip Silence。台词前的呼吸保留,尾音自然衰减,两个箭头带你在标记之间移动。
准备一条录音,在影片播放时表演。有预备计时,你能在耳机里听见 自己,录下的这条会落在对齐画面的位置。人声链 — 高通、压缩器、 齿音消除、均衡和房间混响 — 在你调整时就在响,所以你当场听到 自己的声音将进入的空间,而不是导出时才发现。
内置 1,500 个音效,从嗖声、上升音效到掌声、摔门声和雨声。按名称或类别搜索,点按一个试听,给常用的加上星标,点“添加”即放到播放头位置,并单独放在一条轨上。全部属于公共领域,可以免费用在你发布的视频里。目前已在安卓版提供,iPhone 和 iPad 将在后续更新中获得。
DubWeaver 会根据说话内容写出字幕,支持它会的全部九种语言,并且 字幕可以动起来:逐字输入、卡拉OK、说到哪个词哪个词就亮起、弹出、 淡入。共七种效果,每一种都会在菜单里演示自己:选好一种,一键应用 到整条轨道的所有字幕。标题同样支持,而且播放器里看到的, 就是导出文件里的样子。
十五种风格就在「动画」旁边的标签页里,以取自你自己画面的小预览呈现,每个都已套好风格——你是用看的来挑,而不是读菜单。九种免费;六种付费的里有四种不是调色,而是真正画进画面:七十年代的电视机、像胶片一样呼吸的颗粒、漏光,以及磨损的录像带。风格位于独立轨道,所以同一部影片可以用好几种,导出的文件就是监视器画出的样子。
以完整分辨率导出,字幕可以压进画面,也可以另存为 .srt;立体声 或 5.1,按交付平台要求的响度输出。文件在你的设备上生成、保存在你的 设备上:不用排队等待,也不按分钟计费。
没有 DubWeaver 账号,没有云端,不上传任何东西。应用自身只做下载:AI 模型各一次,内置音效在第一次使用时逐个下载,每个文件都用已知的校验和核对。另外唯一的连接是 Google Play 或 App Store 确认你的订阅 — 那是它们的连接,不是我们的,而且都不会传输你的影片。
在飞机上,在外景地,在地下室。云端配音工具在连接断掉的那一刻, 就不再是工具了。
一份订阅,时长不限,项目不限,没有水印。配一部长片,或者配一百条 短视频,价格一样。
你自己配,或者你指导你的演员。真实监听 — 在测量过的每一台 设备上都是 6 到 34 毫秒,从入门平板到当前 旗舰 — 支持 USB-C 麦克风,并且拒绝通过扬声器录音,好让麦克风永远不会听见自己。
一个人在手机上用过的每一个剪辑应用都是竖屏的,没有一个会旋转。DubWeaver 也一样:在手机上时间线立着,在平板上展开。竖着进来,竖着出去。
指向一条轨道,文字就连同说出的时间一起回来,支持应用所说的九种语言中的任意一种——全部在你的设备上完成,不上传,也不按分钟计费。之后可以用应用自带的字体——和监视器画出来的那一套字形——烧进画面,或者交出 .srt 给需要的人。
大多数配音应用用形容词描述自己的质量。以下是衡量 DubWeaver 的规范,而这些数字取自真实设备,不是从代码推出来的。
广播对声音相对画面的容差不是对称的:音频可以比画面早 40 毫秒,晚 60 毫秒,因为提前到达的声音才是 眼睛会察觉的那一个。2026年9月3日 在四台设备上测量,校准过的一条 录音在每一台设备上的偏差都 不超过 11 毫秒 — 两个平台、从入门平板到当前旗舰,远在容差之内。其中最便宜的一台 不校准时会迟 76 毫秒,那已经在容差 之外。这里每一个数字都取自真实 设备,绝不是从代码推断的。
廉价硬件会谎报自己的延迟,配音应用则继承了这个谎。一台入门平板 声称往返 34 毫秒,实际却是 110 毫秒 — 它三分之二的延迟对任何 礼貌询问的人都是不可见的,等于你演的每一句都慢了十分之一秒。 DubWeaver 不猜测,也不带一张设备型号表:它通过你的耳机播放一串 咔哒声,听它从麦克风回来,然后记住答案。之后同一台平板把录音放在 提前 4 毫秒的位置 — 比未校准的 旗舰机还准,而不用它时是迟 76 毫秒。十五秒,一次,在 世界上任何一台设备上。
DubWeaver 自己混合每一条轨道并推出单一音流,所以轨道之间不可能 彼此漂移 — 没有什么需要纠正,因为从来就只有一个时钟。在四台 设备上测量:四条轨道在每一台上彼此相差 0.0 毫秒 — 不是被纠正到零,而是根本不存在 — 声音相对画面的中位数在四台中的三台是 3–14 毫秒,而容差允许提前 40 毫秒、延后 60 毫秒。编辑器和导出用的是同一个 渲染器,所以你工作时听到的就是文件里的内容。
响度用 K 计权和规范要求的两道门限来测量,而不是平均电平。可以按 −14 LUFS 导出给流媒体,−16 给播客,或 −23 给 EBU R128 广播 — 也可以让混音保持你创作时的样子。
采样峰值低于 0 dBFS,在解码器重建波形之后仍可能削波。 DubWeaver 以四倍采样率估算真峰值,并用前视限制器守住 EBU R128 的 −1 dBTP 上限,这样失真不会发生在听众的播放器上,而你这边 听不出来。
手机相机和录屏工具拍的是可变帧率,而这正是让一段长镜头的配音悄悄 失去同步的原因。DubWeaver 在导入时把它归一为恒定帧率,并把 NTSC 帧率按它本来的精确分数(30000/1001)保存,而不是会漂移的四舍五入 小数。
可以按单声道、立体声或 5.1 交付,并把每条轨道放在房间里该在的 位置:声像、前后、有多少锚定在对白所在的中置,以及送往低频声道的 量——那是 120 Hz 的分频,不是一个推子。与交付宽度 完全一致的素材会逐声道原样通过;比它窄的会被定位,而不是被拉伸。 导入音频比项目更宽的影片时,项目会随之变宽,而不是不声不响地 下混。
配音的第一件事,是有人对着一个小时的音频,判断每句台词从哪里开始。 DubWeaver 会找出来:把轨道读一遍,标出每一句,你再一句一句走过去 — 跳过去、录、再跳。这正是 Pro Tools 里叫 Strip Silence 的那一步, 每一场 ADR 都是这样准备的。它会保留每句台词前的换气,也让尾音自然衰减, 因为正好切在人声开始的地方,是听得出来的。而且在标记任何东西之前, 它先给你看数量:分隔两句台词的静音是一个滑块,数字会随着你拖动而变化 — 轨道只读一次,所以九十分钟的影片重新计数是瞬间的。
人们拿来和我们比较的工具,在它们自己的事情上很出色 — 它们在服务器上合成一个声音。那和把你的表演放到影片上 是两件不同的事,定价和计量方式也不同。
| DubWeaver | 云端配音 | |
|---|---|---|
| AI 在哪里运行 | 在你的设备上 | 在他们的服务器上 |
| 是否上传你的视频 | 从不 | 总是 |
| 没有网络能否工作 | 可以 | 不行 |
| 计费 | 一份订阅,时长不限 | 通常按分钟或按点数 |
| 用谁的声音 | 你的,对着画面演出来 | 合成的,或者它的克隆 |
| 时间线编辑 | 精确到帧,可撤销 | 通常是一个渲染队列 |
| 导出 | 完整分辨率,广播响度,5.1 | 各不相同;常被重编码成预设 |
| 从声音生成字幕 | 在你的设备上,九种语言 | 在他们的服务器上,通常按分钟计费 |
| 是否需要账号 | 不需要 | 需要 |
本对比于 2026 年 9 月 3 日 依据九款具名产品 — HeyGen、ElevenLabs、Rask AI、 CapCut Pro、KineMaster、InShot、Descript、Adobe Audition 以及离线的分轨应用 — 各自公开的说明与标价复核。当时入门级云端 配音为每分钟视频 0.55 至 2.40 美元。它们的功能和价格会变;选择之前 请自行核对。
基础版是一个真能用的编辑器,不是演示:你的影片能打开, 你的配音能对着画面录制,没有水印也不会过期。Pro 就是配音工作室真正收费的那些本事。
| 基础版 | Pro | |
|---|---|---|
| 项目 基础版保留五个 — 够做一部短片、一支预告和几场戏。 如果订阅结束,你做过的每个项目都还在;停下来的只是开始下一个。 |
5 | 不限 |
| AI 人声分离 去掉原声,保留音乐和音效。它在你的设备上运行,所以没有什么 可计量的:分离两分钟的一场戏,或者两小时的长片,想做多少次都行, 价格一样。云端工具按视频分钟收费,是因为干活的那台电脑是他们的。 |
— | 不限次数 |
| 人声工作室 把在卧室里用手机录下的一条声音,放进电影里坐稳:房间声被 去掉,音量不再忽高忽低,齿音不再刺耳,人声落在对白该在的位置。 高通、压缩器、齿音消除、三段均衡和房间混响 — 在你调整时就能 听见,而不是导出时才发现。已经打开的效果,在订阅结束后仍然继续 工作。 |
— | 有 |
| 滤镜 九种风格免费,每种都可调强度并带暗角:浓郁、琥珀、冷钢、电影感、余烬、午夜、黑白、铂金与浓墨。订阅再添六种,其中四种不是调色,而是真正画进画面里:七十年代电视机的辉光与扫描线、像胶片一样呼吸的颗粒、从画面边缘涌入的暖色漏光,以及带着跟踪线与信号丢失的磨损录像带。双色调与分离色调也一同加入。选择方式就是用看的——取自你自己画面的小预览,早已套好风格——而且它位于独立轨道,所以同一部影片可以用好几种。 |
九种风格 | 全部十五种 |
| 自动闪避 音乐与音效垫会自己在对白下方降下来,起音和释放由你设定。 |
— | 有 |
| 导出 完整分辨率、独立 5.1,以及按流媒体、播客或 EBU R128 广播 归一化的响度。 |
最高 720p,立体声 | 源分辨率、5.1、所有目标 |
| 两个方案都没有水印 不会在你的片子上盖任何东西,任何分辨率都不会,两个方案都不会。基础版是一个更小的编辑器,不是倒计时:它不会过期,也不会往你导出的成片上加任何东西。 |
有 | 有 |
| 台词检测 找出轨道里每一句台词的起止,并全部标记——配音的第一步, 也就是 Pro Tools 里的 Strip Silence。它保留台词前的呼吸,让尾音衰减, 并在标记前先给出数量。工作在你的设备上完成, 所以送出去不花一分钱。 |
有 | 有 |
| 对着画面录制 预备计时、耳机监听,录下的这条会落在对齐画面的位置。 |
有 | 有 |
| 所有轨道共用一个时钟 DubWeaver 自己混合每条轨道,所以它们不会漂移,而且编辑器和 导出用的是同一个渲染器。 |
有 | 有 |
| 精确到帧的编辑 分割、修剪、波纹、吸附、标记、淡入淡出、音量和声像 — 以及不限次数的撤销。 |
有 | 有 |
| 字幕 导入和导出 .srt,或者把字幕烧进画面。 |
有 | 有 |
| 从声音写出字幕 指向一条轨道,文字就连同说出的时间一起回来,支持应用所说的九种语言中的任意一种,听到的语言也会标注在新建的轨道上。全部在你的设备上运行,没有按分钟计费这回事。基础版可以在一个项目里写,项目内的轨道数量不限。 |
一个项目 | 每个项目 |
| 离线,且私密 一切都在设备上运行。无论有没有订阅,你的影片都不会被上传。 |
有 | 有 |
如果订阅结束,你的项目仍然是你的, 也仍然打得开。基础版收窄的是可以改动的部分,而不是项目已经 在做的事:你交付过的混音,会继续按交付时的样子发声。
首月免费。之后是一份订阅,没有水印,没有项目数量限制, 也不按分钟收费 — 一部两小时的长片,你想分离多少次都是同一个价。
用七个月的价钱,得到全部。
全部功能,按月计。
如果订阅结束,你保留项目和基础编辑工具, 所以随时都能手工收尾,把作品拿出来。价格以美元标示;实际价格由你的 应用商店按当地货币显示。
有。基础版是一个真能用的编辑器,而不是试用:它不会过期,不加水印,可以保留五个项目,在精确到帧的时间线上剪辑,对着画面录配音,烧录或导出字幕,并以立体声导出到 720p。订阅会加上 AI 人声分离、人声工作室、自动闪避、完整分辨率与 5.1 导出、广播响度目标、六种付费滤镜,以及不限数量的项目。第一个月免费。
可以,而且导出后与你看到的完全一致。共七种效果:带光标的逐字输入、逐词出现、卡拉OK、说到哪个词哪个词就亮起、弹出、淡入,以及不加效果。每一种都会在菜单里演示自己,所以你挑的是动作而不是名字。设置好一条字幕,一键即可应用到整条轨道;可以选择词亮起的颜色,加上霓虹或阴影,画面下方有内容时还能把字幕放到顶部。标题同样支持。全部处理都在设备上完成:播放器里看到的效果,就是烧进文件里的效果。
可以,而且是真的画上去的,不是伪造的。十五种风格就在「动画」旁边的「滤镜」标签页里,每一种都以取自你自己画面的小预览呈现,已经套好风格,所以你是用看的来挑。九种免费:浓郁、琥珀、冷钢、电影感、余烬、午夜、黑白、铂金与浓墨,每种都可调强度并带暗角。订阅再添六种,其中四种不是调色,而是画在画面之上:七十年代电视机的辉光与扫描线、像胶片一样呼吸的颗粒、从画面边缘涌入的暖色漏光,以及带着跟踪线与信号丢失的磨损录像带。双色调与分离色调也一同加入。每种风格都位于独立轨道,所以同一部影片可以用好几种,而导出的文件就是监视器画出的样子。
可以,只要素材本来就是竖的。画面形状取自你导入的第一个视频,所以 9:16 的素材按 9:16 剪辑、按 9:16 导出。横着的电影就横着剪、横着交付——你给它什么形状,它就还你什么形状。
这是这个应用里最短的一条路。导入你自己的视频,把原声抽走,对着你自己的画面录下另一种语言,再把同一个文件用另一个声音导出。音乐和音效留在原处。
它能导入 .srt,让你自己撰写并对时字幕,用应用自带的字体把字幕烧进画面,也能导出 .srt 交给需要的人。烧进画面的字幕带的是编辑器里显示的样式,而不是播放器的默认设置。它会在你的设备上把文字写出来,支持应用所说的九种语言中的任意一种:指向一条轨道,文字就连同说出的时间一起回来,听到的语言也会标注在新建的轨道上。你也可以自己写,或者导入 .srt。
不会。AI 在你自己的手机或平板上运行,所以没有服务器时间需要计费:分离两分钟的一场戏和两小时的长片,费用相同,再做一次也不多收。云端配音工具按分钟或按点数计量,是因为干活的那台电脑是他们的。DubWeaver 是每月 $6.99 或每年 $49.99,无论你放进去多少内容。
不会。视频、音频和项目都保存在你的设备上,别处没有。没有 DubWeaver 账号,也没有云端。应用自身只下载它需要的文件:AI 模型各下载一次,内置音效在你第一次使用时逐个下载,每个文件都用已知的校验和验证。另外唯一的连接是 Google Play 或 App Store 确认你的订阅,那是它们的连接而不是我们的。这些都不会传输你的视频、音频或项目。
是的,模型下载完之后就可以。人声分离、录制、混音和导出全部在设备上完成,完全不需要连接。内置音效在你第一次播放或添加时需要连接,之后就保存在设备上。这些下载逐个对照已知校验和验证,是应用发出的全部请求;另外唯一的连接是商店确认你的订阅。
可以。DubWeaver 内置 1,500 个音效——嗖声、上升音效、掌声、摔门声、雨声、卡通弹跳声等,分成 52 个类别——全部属于公共领域(CC0),所以你可以把它们用在发布的任何作品里,包括商业作品,也不需要署名。你可以用自己的语言按名称或类别搜索,点按试听,给常用的加上星标,一点就能添加到播放头位置。所有方案都包含,基础方案也一样,在 Android 应用中提供。
你会说的任何语言。DubWeaver 去掉原声并录下你的声音;它不翻译,也不合成,所以你不会被一份「支持的声音」清单限制住。应用界面本身有九种语言,这和你配成哪种语言是两回事。
九种:英语、西班牙语、葡萄牙语、法语、意大利语、德语、日语、简体中文和俄语。它会跟随你设备的语言,你也可以随时切换。如果你的语言不在这九种之内,应用会保持英语,而不是给你一个翻译了一半的界面。
它用的是和桌面工具同一类的模型,而且在什么设备上跑结果都一样:2026年9月3日 的测量显示,无论是当前的手机还是几年前的入门机型,人声都下降约 11 dB,而音乐与音效垫在三台上都只变动 0.0 dB。较旧的设备只是等得久一些,并不会得到更差的分离。结果的差别来自素材而不是硬件:一段本来就分不干净的混音,在这里也不会分得完美。如果影片本身带有音乐与音效轨道,DubWeaver 会直接用它,那比任何模型都好。
符合,而且我们把规范名字写出来。声音相对画面保持在 EBU R37 和 ITU-R BT.1359 的窗口内,即提前 40 毫秒、延后 60 毫秒。响度按 ITU-R BS.1770 用 K 计权和门限测量,并按流媒体 -14 LUFS、播客 -16 或 EBU R128 广播 -23 导出。真峰值以四倍采样率估算,并限制在 EBU R128 的 -1 dBTP 上限。
校准器运行之后,一条录音距离你演绎的位置不超过 11 毫秒 — 测量过的每一台设备都是如此,从入门平板到当前旗舰,这些都是 2026年9月3日 在设备本身上测的。不校准时,其中最便宜的一台会迟 76 毫秒。EBU R37 的广播容差允许音频比画面早 40 毫秒、晚 60 毫秒,所以这远在范围之内。这种不对称是规范里有意为之:提前到达的声音才是眼睛会察觉的那一个。DubWeaver 每次测试都在真实设备上测量这一点,而不是从代码里推断。
有些设备少报自己的音频延迟,还有少数根本不报。从"编辑"菜单运行校准器:它通过你的耳机播放一串咔哒声,听它从麦克风回来,然后记住答案,这样在任何设备上录音都会落在你演绎的位置。一台入门平板声称 34 毫秒,实际要 110 毫秒,不用校准器时录音会迟 76 毫秒 — 已经在广播容差之外。用了之后,同一台平板会提前 4 毫秒,比未校准的旗舰机还准。它是可选的,大约十五秒,不用它配音照样能做。
可以。立体声或分离式 5.1,保持源素材的分辨率,并按流媒体、播客或广播的响度目标做归一化。每条轨道是被摆放,而不是被拉伸:声像、前后、中置,以及送往低频声道的一路——那是 120 Hz 的分频,不是一个推子。
你的项目和一套基础剪辑工具都还在,所以已经做完的活儿仍然可以打开、手工收尾、导出。停下来的是「开始下一件事」:AI 人声分离、人声链路、闪避,以及完整分辨率的 5.1 交付。已经打开的效果仍然可以调整或关掉。在免费月结束前取消不花一分钱。
能,而且配音工作真正开始的第一步就是这个。DubWeaver 把轨道读一遍,标出每句台词的起点 — 正是 Pro Tools 里叫 Strip Silence 的那一步,每一场 ADR 都是这样准备的。它会保留每句台词前的换气,也让尾音自然衰减,而不是正好切在人声开始的地方,那是听得出来的。在标记任何东西之前你就能看到数量,分隔两句台词的静音是一个滑块,数字会随着你拖动而变化:轨道只读一次,所以九十分钟的影片重新计数是瞬间的。之后你一句一句地走过这些标记:跳到台词、录、再跳到下一句。它是标记而不是切割,所以你不认同的检测结果,忽略即可,不必撤销。
通过 Google Play 在安卓手机和平板上运行,通过 App Store 在 iPhone 和 iPad 上运行。内置音效目前已在安卓版中提供,iPhone 和 iPad 将在后续更新中获得。 macOS 版本同样可以运行 —— 展示页里的影片就是在一台 Mac 上拍的 —— 但尚未发布,因此目前还无法安装。2026年9月3日,在四台真实设备上进行了测量 — 从入门平板到当前旗舰 — 覆盖了两个平台以及手机和平板两种布局,四条音频轨道同时播放,没有任何一台出现中断。人声分离是重活:它需要一台还算新的设备和足够的空闲内存,设备做不到时应用会如实告诉你。


 Android
 iOS / iPadOS
 Windows
 Linux